Jev는 타입세이프(TypeSafe AI)가 2026년 9월 15일 얼리 액세스로 공개한 모델입니다. 글을 만들지 않고 코드가 그대로 쓸 수 있는 결정만 돌려줍니다. LLM에게 JSON을 부탁하고 파싱이 깨질까 검증하던 자리에 들어가는 모델이라고 보면 됩니다.
이 문서는 Jev로 실제 기능을 만들 때 필요한 것을 한 곳에 모아둔 레퍼런스입니다. 처음부터 읽어도 되고, 확신도 임계값이나 토큰 한도처럼 필요한 항목만 찾아봐도 됩니다. 모델의 배경과 발표 내용은 Jev 공개 소식에서 다룹니다.
기준 모델
jev-1.13.0 (별칭 jev-latest)
확인 날짜
2026년 9월 18일
기준 문서
docs.typesafe.ai 공식 문서
작업 환경
Windows PowerShell 또는 WSL
Jev가 하는 일
Jev에 보내는 요청은 두 부분입니다. 판단의 재료인 상태(state)와 그 재료에 대해 묻는 질문(questions)입니다. 응답은 질문마다 하나씩, 요청에서 쓴 키 그대로 돌아옵니다.
{
  "state": "결제가 3일째 실패합니다. 매출이 계속 빠지고 있어요. 급합니다.",
  "model": "jev-latest",
  "questions": {
    "is_urgent": {
      "type": "noul",
      "instructions": "이 메시지가 긴급함을 나타내는가?"
    }
  }
}
핵심은 답의 모양을 요청에서 미리 못 박는다는 점입니다. 선택지를 세 개 주면 답은 그 세 개 중 하나이고, 등급을 다섯 개 주면 점수는 그 안에 들어옵니다. 스키마를 벗어난 값이 나오지 않으므로 출력을 다시 파싱하거나 형식이 깨졌을 때를 대비한 재시도가 필요하지 않습니다.
그래서 잘 맞는 일과 맞지 않는 일이 분명하게 갈립니다.
| 잘 맞는 일 | 맞지 않는 일 |
|---|---|
| 분류, 라우팅, 점수 매기기, 예·아니오 판정 | 문장·코드·요약 생성 |
| 실시간 분기가 필요한 판단 | 여러 단계의 추론이 필요한 문제 |
| 수만 건을 훑어 피처로 만드는 작업 | 계산, 개수 세기, 날짜 비교 |
| LLM 입출력 검사와 가드레일 | 이미지, 오디오, 영상 입력 |
시작 전 준비
Jev는 지금 대기명단을 거쳐 순서대로 접근 권한을 주는 얼리 액세스 단계에 있습니다. typesafe.ai에서 신청하고 접근 권한을 받은 다음 아래를 준비합니다.
사전 준비
0/4 완료
$env:TYPESAFE_API_KEY = "여기에_발급받은_키"

# 현재 세션에만 적용됩니다. 영구 설정은 아래를 씁니다.
[Environment]::SetEnvironmentVariable("TYPESAFE_API_KEY", "여기에_발급받은_키", "User")
export TYPESAFE_API_KEY="여기에_발급받은_키" # 셸을 다시 열어도 유지하려면 echo 'export TYPESAFE_API_KEY="여기에_발급받은_키"' >> ~/.bashrc
코드를 쓰기 전에 감을 잡으려면 콘솔의 플레이그라운드에 텍스트를 붙이고 질문을 하나 넣어보는 편이 빠릅니다. 같은 요청을 화면에서 만들고 그대로 코드로 옮길 수 있습니다.
첫 호출
엔드포인트는 하나입니다. POST https://api.typesafe.ai/v1/systemone으로 보내고 Authorization: Bearer 헤더에 키를 넣습니다.
curl -X POST https://api.typesafe.ai/v1/systemone \
  -H "Authorization: Bearer $TYPESAFE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "state": "결제가 3일째 실패합니다. 급합니다.",
    "model": "jev-latest",
    "questions": {
      "is_urgent": { "type": "noul", "instructions": "Does this convey urgency?" }
    }
}'# pip install typesafe-sdk (uv를 쓰면 uv add typesafe-sdk)
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient
with TypeSafeClient() as client:
response = client.system_one(
state={"document": "I was charged twice. Please fix this ASAP."},
questions={
"billing": Noul(instructions="Is this ticket about billing?"),
"tone": Choice(
instructions="What is the customer's tone?",
criteria={"calm": None, "frustrated": None, "angry": None},
),
"urgency": Score(
instructions="How urgent is this ticket?",
criteria=["can wait", "this week", "today"],
),
},
)
print(response.nouls["billing"].noul)
print(response.choices["tone"].choice)
print(response.scores["urgency"].score)// npm install @typesafe-ai/sdk (Node.js 20 이상)
import { choice, TypeSafeClient } from "@typesafe-ai/sdk";
const client = new TypeSafeClient();
const response = await client.systemOne({
state: { document: "I was charged twice. Please fix this ASAP." },
questions: {
category: choice("What is this ticket about?", {
billing: null,
technical: null,
other: null,
}),
},
});
console.log(response.answers.category.choice);SDK에는 재시도 정책이 기본으로 들어 있습니다. 429나 529가 오면 지수 백오프로 다시 시도하고 retry-after 헤더를 지킵니다. HTTP API를 직접 부를 때는 이 처리를 직접 넣어야 합니다.
계정이 쓸 수 있는 모델 목록은 GET /v1/models로 확인합니다.
$ curl https://api.typesafe.ai/v1/models \
    -H "Authorization: Bearer $TYPESAFE_API_KEY"
{"models":[{"name":"jev-latest","description":"...","release_date":"..."}]}
질문 세 가지
질문마다 ID와 type, instructions가 필요합니다. ID는 내 코드가 쓰는 키이고 모델에는 전달되지 않습니다. 그래서 ID가 아무리 설명적이어도 질문 본문은 instructions에 전부 써야 합니다.
| 종류 | 언제 쓰는가 | 응답 필드 |
|---|---|---|
| Choice | 순서 없는 선택지 중 하나를 고를 때 | `choice`, `probabilities`, `confidence` |
| Score | 정의한 등급 사이의 위치를 잴 때 | `score`, `legend`, `probabilities`, `confidence` |
| Noul | 예·아니오 확률 자체가 신호일 때 | `noul` |
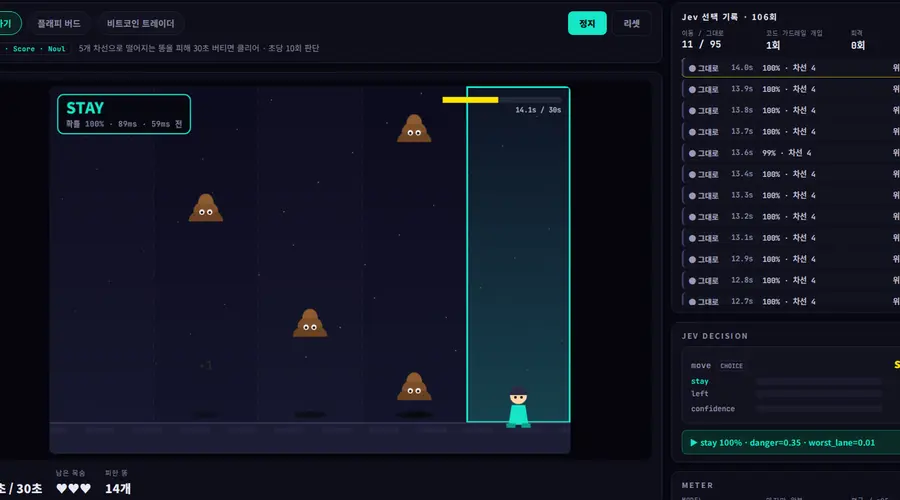
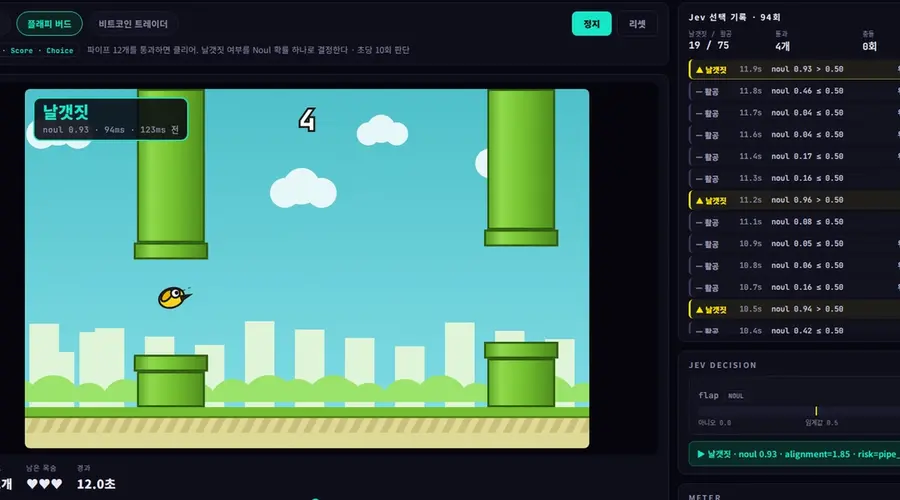
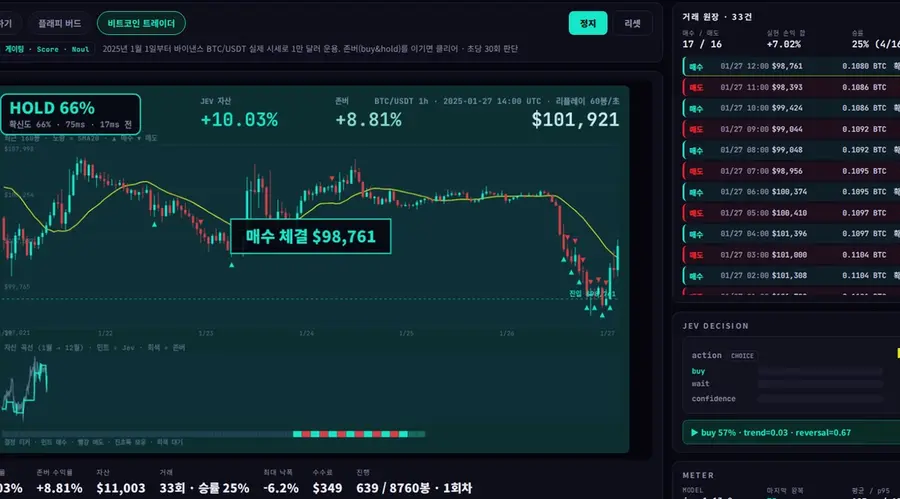
세 종류를 한 요청에 섞어 보내면 답도 한꺼번에 돌아옵니다. 아래는 이 세 질문을 실제 게임 세 개에 붙여 돌린 화면입니다. 각 화면 아래 카드가 그 순간의 답이고, 왼쪽 아래 JSON이 모델이 본 state 전부입니다. 두 번째 화면에서는 코드가 미리 계산한 예측 궤적을 점선으로 그려 넣었고, 세 번째 화면에서는 고른 답의 확률이 57%인데 확신도가 0.15로 떠 있습니다.
Choice: 선택지 하나 고르기
criteria는 선택지 이름과 설명의 맵입니다. 설명이 필요 없으면 값에 null을 넣습니다. 한 질문에 선택지는 255개까지 넣을 수 있으니 후보를 미리 줄이지 말고 전체 목록을 주는 편이 낫습니다. 목록이 입력을 다 덮지 못할 가능성이 있으면 other 같은 탈출구를 꼭 넣습니다.
{
  "department": {
    "type": "choice",
    "instructions": "Which team should handle this?",
    "criteria": {
      "billing": "Payments, invoicing, refunds",
      "technical": "Bugs, outages, integrations",
      "sales": "Pricing, upgrades, new accounts"
    }
  }
}
응답의 probabilities는 전체 선택지에 대한 분포이고 합이 1입니다. choice에는 그중 확률이 가장 높은 선택지가 들어옵니다.
Score: 등급 사이의 위치 재기
criteria는 낮은 쪽에서 높은 쪽으로 정렬한 등급 설명 배열입니다. 최소 2개, 최대 10개까지 넣습니다. 응답의 score는 등급 사이에 걸칠 수 있는 확률 가중 평균이고, legend가 각 번호에 어떤 설명이 붙었는지 되돌려줍니다.
{
  "frustration": {
    "type": "score",
    "instructions": "How frustrated is the customer?",
    "criteria": ["Calm", "Frustrated", "Very angry"]
  }
}
등급 설명은 서로 구분되게 씁니다. 구분해서 설명할 수 없는 등급을 억지로 늘리면 분포가 퍼지고 확신도만 떨어집니다.
Noul: 예·아니오 확률
Noul은 noul 하나만 돌려줍니다. 0에 가까우면 아니오, 1에 가까우면 예, 0.5 근처면 모델이 양쪽에 같은 확률을 준 상태입니다. Noul에는 confidence가 없습니다. 값 자체가 이미 확률이기 때문입니다.
`파이썬 실력이 좋은가?`라는 Noul이 0.5를 돌려줬다면 실력이 중간이라는 뜻이 아니라 예와 아니오가 반반이라는 뜻입니다. 수준을 재려면 등급을 정의한 Score를 쓰고, 예·아니오로 끊으려면 `이력서에 업무에서 파이썬을 썼다고 적혀 있는가?`처럼 조건을 분명하게 씁니다.
상태를 설계하는 법
state는 문자열, JSON 객체, 텍스트 배열 중 하나입니다. 대부분은 객체를 쓰는 편이 낫습니다. 각 부분에 이름이 붙어서 질문이 어디를 봐야 하는지 가리킬 수 있습니다.
숫자를 누가 만드느냐도 같이 정해야 합니다. 공식 약점 문서가 세기와 산술을 약점으로 적어둔 만큼, 계산은 코드에서 끝내고 모델에는 그 숫자를 보고 내리는 판단만 맡기는 편이 안전합니다. 앞서 본 플래피 버드 화면의 점선이 그 예입니다. 코드가 0.35초 뒤 위치를 미리 계산해 state에 넣고, 모델은 그 두 숫자 중 어느 쪽이 구멍에 가까운지만 답합니다.
| 형태 | 쓰는 경우 |
|---|---|
| 문자열 | 메시지 한 건, 문단 하나처럼 단순한 입력 |
| 객체 | 이름 붙은 필드, 관련 기록, 애플리케이션 상태 |
| 배열 | 메시지나 레코드의 나열 |
객체로 넣었으면 질문에서 경로를 직접 가리킵니다. 백틱을 포함해 ticket.messages[0].text처럼 씁니다.
questions = {
    "refund_requested": {
        "type": "noul",
        "instructions": "Does `ticket.messages[0].text` request a refund?",
    },
    "policy_supports_refund": {
        "type": "noul",
        "instructions": (
            "Does `refund_policy` support the refund requested "
            "in `ticket.messages[0].text`, given `order.charges`?"
        ),
    },
}
상태에 관련 없는 내용을 많이 넣으면 정확도가 떨어집니다. 공식 문서도 검색과 필터링을 코드에서 먼저 하고 질문에 필요한 필드만 보내라고 권고합니다. 질문을 여러 개 넣는 것은 거의 무료지만 상태를 키우면 비용과 정확도 양쪽에 영향이 옵니다.
확신도로 행동을 나누기
Choice와 Score의 답에는 confidence가 0에서 1 사이로 함께 옵니다. 확률 분포가 한 곳에 몰려 있으면 높고, 퍼져 있으면 낮습니다. 공식 문서가 권하는 출발점은 세 구간입니다.
- 높음: 자동으로 처리합니다.
- 중간: 사용자 확인을 받거나 검토 대기로 표시합니다.
- 낮음: 실행하지 않고 사람에게 넘기거나 다른 경로로 보냅니다.
경계를 어디에 둘지는 실수했을 때의 비용이 결정합니다. 같은 시스템 안에서도 작업마다 기준이 달라야 합니다.
여기서 자주 오해하는 게 하나 있습니다. 확신도는 선택지가 몇 개냐가 아니라 확률이 한쪽으로 얼마나 몰렸느냐를 요약한 값입니다. 선택지가 둘뿐인 상황이라도 답이 분명하면 확신도가 0.9를 넘고, 반대로 57 대 43처럼 갈리면 0.15까지 떨어집니다. 앞서 본 트레이딩 화면이 그 경우입니다. 고른 답의 확률은 57%인데 확신도는 0.15로 떠 있습니다. 이런 자리에서 확신도만 보고 거르면 행동해야 할 순간을 통째로 놓칩니다.
action = response.answers["action"]
confidence = action.confidence

if confidence < 0.5:
    # 모델이 스스로 모르겠다고 말한 구간입니다.
    route_to_human(user_message)

elif action.choice == "check_balance":
    # 잘못 눌러도 되돌릴 수 있는 작업입니다.
    show_balance(account_id)

elif action.choice == "approve_transfer":
    if confidence > 0.9:
        confirm_then_execute(account_id)
    else:
ask_user_to_confirm(account_id)확신도는 probabilities에서 계산한 요약값입니다. 통계 알고리즘을 직접 쓸 생각이라면 확신도 대신 원본 분포를 쓰는 편이 맞습니다. 여러 선택지 중 최선만 고르면 되는 상황이라면 임계값 없이 확률이 가장 높은 답을 쓰면 됩니다.
확률이 보정됐다는 말은 확신도가 0.8인 답들을 모아보면 그 근처 비율로 맞는다는 뜻입니다. 개별 답 하나가 맞는다는 보장이 아닙니다. 임계값은 반드시 내 데이터로 시험해서 정합니다.
실전 패턴 네 가지
공식 문서는 네 가지 구성 패턴을 정리해두었습니다. 네 개 모두 판단을 잘게 쪼개고 조합은 코드가 맡는다는 같은 원칙에서 나옵니다.
투기적 팬아웃
필요할지 모르는 질문까지 한 번에 다 보내고, 무엇을 쓸지는 코드가 뒤에서 고릅니다. 질문은 병렬로 평가되므로 개수를 늘려도 응답 시간이 거의 늘지 않습니다. 티켓 분류를 예로 들면 카테고리와 함께 버그 심각도, 재현 절차 유무, 환불 요청 여부, 불만 정도를 한 번에 묻습니다. 버그 신고가 아니면 심각도 답은 코드에서 버립니다.
공식 병렬 질문 쿡북은 13개 질문을 한 호출에 묶었을 때 따로 부르는 것보다 12.2배 저렴하고 10.0배 빨랐으며 답은 달라지지 않았다고 보고합니다.
확신도 게이팅
답이 무엇인지와 그 답으로 행동할지를 따로 다룹니다. 답은 choice가 알려주고 행동 여부는 confidence가 결정합니다. 위 라우팅 코드가 이 패턴의 최소 형태입니다.
합성 점수
복잡한 판단 하나를 여러 개의 독립된 Score로 쪼개고 가중치를 코드에서 곱합니다. 이력서 심사라면 파이썬 깊이, 팀 리딩 경험, 시스템 설계 경험, 낯선 영역 적응력을 각각 5단계로 물어본 다음 역할에 따라 다르게 조합합니다.
py      = response.answers["python_depth"].score / 4
lead    = response.answers["team_leadership"].score / 4
arch    = response.answers["system_design"].score / 4
general = response.answers["generalist"].score / 4

# 시니어 개발자 기준
ic_score = (0.40 * py) + (0.10 * lead) + (0.40 * arch) + (0.10 * general)

# 엔지니어링 매니저 기준
em_score = (0.15 * py) + (0.40 * lead) + (0.20 * arch) + (0.25 * general)
우선순위가 바뀌면 프롬프트를 다시 쓰는 대신 계수만 고칩니다. 최종 점수가 어떻게 나왔는지 코드에 남는다는 점이 이 방식의 실제 이득입니다.
인텐트 라우팅
들어온 요청을 분류해서 각각 맞는 처리기로 보냅니다. 결정적 코드로 끝낼 일, 전문 LLM에 넘길 일, 사람이 봐야 할 일을 갈라놓는 자리입니다. Jev를 문 앞에 두고 무거운 모델을 필요한 때만 부르는 구성이 비용과 속도 양쪽에서 유리합니다.
모델, 가격, 한도
현재 공개된 모델은 하나입니다. 별칭 jev-latest가 jev-1.13.0을 가리키고, jev-preview도 지금은 같은 버전을 가리킵니다. 별칭은 새 버전이 나오면 움직이므로 확신도 임계값을 특정 버전에 맞춰 조정했다면 버전 ID를 직접 고정하는 편이 안전합니다. 응답의 model 필드에 실제로 답한 버전이 들어옵니다.
| 항목 | 값 |
|---|---|
| 모델 ID | `jev-1.13.0` |
| 가격 | 입력 100만 토큰당 0.042달러, 출력 무료 |
| 속도 제한 | 초당 25만 토큰, 분당 1,200요청 |
| 토큰 예산 | 요청당 6만 4천, 상태와 가장 긴 질문 합계는 3만 2천 |
| 입력 | 텍스트만. 문자열, JSON 객체, 텍스트 배열 |
타입세이프는 수요가 많아 속도 제한이 예고 없이 바뀔 수 있다고 공지했습니다. 더 높은 한도는 커스텀·엔터프라이즈 계약에서 제공합니다. 파인튜닝이나 LoRA는 없습니다. 같은 가중치를 모든 계정이 쓰고, 도메인에 맞추는 일은 상태와 질문 쪽에서 합니다.
자주 막히는 지점
타입세이프는 jev-1.13의 약점을 따로 문서로 공개했습니다. 실제로 붙여보기 전에 한 번 읽어두면 헛수고를 줄일 수 있습니다.
| 문제 | 대신 이렇게 |
|---|---|
| 지시문을 문자 그대로 읽음 | 조건을 정확히 쓰고 경계 사례를 criteria에 넣기 |
| 계산과 개수 세기가 약함 | 산술은 코드에서 하고 항목별로 질문 나누기 |
| 날짜 비교가 불안정함 | 날짜 조각을 Choice로 뽑고 비교는 코드에서 |
| 여러 단계를 거치는 질문에 약함 | 질문을 직접적으로 쓰고 관련 필드를 이름으로 지목 |
| 상태가 크고 잡다하면 정확도 하락 | 코드에서 먼저 걸러 필요한 필드만 보내기 |
| 적대적 입력에 흔들릴 수 있음 | criteria를 명시적으로 쓰고 경계 사례를 미리 시험 |
| 지시문과 criteria가 어긋나면 혼란 | 둘을 같은 방향으로 맞춰 쓰기 |
| 질문 형태를 바꾸면 값이 안 맞음 | Noul에서 맞춘 임계값을 Choice에 옮기지 않기 |
| 텍스트 생성은 못 함 | 생성은 생성 모델에 맡기기 |
특히 헷갈리기 쉬운 것은 질문 형태를 바꿨을 때 값이 맞지 않는 문제입니다. 같은 내용을 Noul로 묻는 것과 예·아니오 Choice로 묻는 것은 서로 다른 질문입니다. 공식 문서의 예를 보면 같은 티켓에서 Noul이 0.22를 준 반면 Choice는 no에 0.99를 줬습니다. 하나의 Choice는 선택지들 사이의 상대적 비교이고, 선택지마다 따로 물은 Noul은 각각 절대적인 판정입니다. 그래서 여러 Noul의 합이 1이 되지도 않습니다.
한국어로 쓸 때 주의할 점
공식 문서는 Jev의 주 학습 언어가 영어이며 한국어를 포함한 CJK 문자는 처리하지만 정확도가 같지 않다고 밝혔습니다. 영어가 아닌 작업에 쓰기 전에 자기 데이터로 시험하고 확신도를 특히 주의해서 보라는 안내가 붙어 있습니다.
실무에서 쓸 만한 절충안은 상태와 지시문의 언어를 분리하는 것입니다. 상태에는 원문 한국어를 그대로 넣고, 질문의 instructions와 criteria는 영어로 쓰는 방식입니다. 선택지 이름도 billing이나 refund처럼 영어 식별자로 두면 코드에서 분기하기도 편합니다. 어느 쪽이 정확한지는 짐작하지 말고 같은 데이터 100건 정도로 양쪽을 돌려 비교해봅니다.
{
  "state": "주문 취소하고 환불해주세요. 벌써 2주째입니다.",
  "questions": {
    "환불요청": {
      "type": "noul",
      "instructions": "고객이 환불을 요청했나요?"
    }
  }
}{
"state": { "message": "주문 취소하고 환불해주세요. 벌써 2주째입니다." },
"questions": {
"refund_requested": {
"type": "noul",
"instructions": "Does `message` explicitly ask for a refund?",
"criteria": {
"true": "The customer asks for money back",
"false": "No refund is requested"
}
}
}
}코딩 에이전트에 붙이기
타입세이프는 코딩 에이전트용 스킬을 공개했습니다. 질문 세 종류와 패턴, 요청 형식을 에이전트가 읽고 쓰게 만드는 스킬이며 설치하면 바로 동작합니다.
claude plugin marketplace add typesafe-ai/skills
claude plugin install typesafe@typesafe-ai

# 업데이트
claude plugin marketplace update typesafe-ai
claude plugin update typesafe@typesafe-ai
npx skills add typesafe-ai/skills --skill typesafe-ai

# 기본은 프로젝트 로컬 설치입니다. 전역 설치는 -g를 붙입니다.
# 업데이트는 npx skills update
설치 뒤에는 Claude Code에서 /typesafe:typesafe-ai로 직접 부르거나, 다른 에이전트에서는 TypeSafe 스킬을 써서라고 요청에 적으면 됩니다. 에이전트가 질문을 호출마다 하나씩 나눠 보내는 습관이 있으니, 여러 질문을 한 호출에 묶으라는 지시를 함께 주는 편이 좋습니다.
에이전트에게 맡길 때 사람이 꼭 검토해야 하는 것은 질문 문장과 임계값 상수입니다. 두 가지를 파일 하나에 모아두면 리뷰가 훨씬 수월해집니다. 공식 문서도 같은 방식을 권합니다.
FAQ
지금 바로 쓸 수 있나요?
LLM을 완전히 대체하나요?
환각이 없다는 말은 답이 항상 맞다는 뜻인가요?
이미지나 PDF를 넣을 수 있나요?
내 데이터로 파인튜닝할 수 있나요?
질문을 몇 개까지 한 번에 보낼 수 있나요?
가중치가 공개되어 있나요?
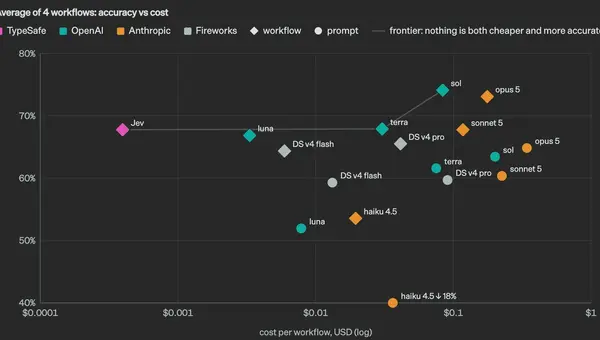
타입세이프가 공개한 Jev, 글을 쓰지 않고 결정만 내리는 모델
타입세이프가 9월 15일 시스템 원 모델 Jev를 공개하고 DCVC가 주도한 4,000만 달러 시드 투자를 발표했습니다. 글을 만들지 않고 타입이 정해진 결정만 내놓는 모델이며, 회사가 내세운 수치와 개발자들이 지적한 조건을 함께 정리했습니다.
AI 자동화 하네스 완전 가이드: 프롬프팅과 컨텍스트 엔지니어링으로 AI 워크플로우 구축하기
AI 하네스는 단순 프롬프트를 넘어, 프롬프팅·컨텍스트·도구·검증을 하나의 파이프라인으로 묶은 자동화 시스템입니다. Claude Code와 CLAUDE.md를 중심으로 실전 하네스를 직접 설계하고 운영하는 방법을 처음부터 끝까지 정리했습니다.
컨텍스트 엔지니어링 완전 가이드 (2026년 3월 기준)
프롬프트 엔지니어링의 시대는 저물고, 컨텍스트 엔지니어링의 시대가 열렸습니다. LLM에 무엇을, 언제, 어떻게 전달할지를 설계하는 컨텍스트 엔지니어링의 핵심 개념부터 실전 패턴까지 2026년 기준으로 정리했습니다.
MCP(Model Context Protocol) 완전 가이드
MCP란 무엇인지부터 아키텍처, 전송 방식, Claude Code 설정법, 인기 서버 목록, 직접 서버 만들기, 보안 주의사항까지 한 곳에 정리했습니다.