DeepSeek가 9월 10일 DeepSeek-V4.1-Flash를 정식 공개했습니다. API에서는 deepseek-flash라는 모델 ID로 호출하며, 같은 날 오픈 웨이트와 기술 보고서도 공개했습니다. 새 모델은 텍스트와 이미지를 입력받아 텍스트를 생성하는 멀티모달 모델입니다. 이름에 Flash가 붙었지만 이번 발표는 응답 속도만 높인 소규모 업데이트가 아닙니다. 긴 입력을 처리할 때 드는 연산과 캐시 비용을 줄이기 위해 모델 구조와 KV 캐시 방식을 함께 바꿨습니다.
이번 변화는 기존 DeepSeek API를 쓰는 개발자에게 바로 영향을 줍니다. 새 모델을 선택하는 방법이 바뀌었고, 이전 Flash 모델은 이미 제공이 종료됐습니다. V4 Pro 요청도 9월 14일부터 새 Flash로 임시 연결됩니다. 모델을 명시적으로 선택해 운영하던 서비스라면 품질 비교뿐 아니라 모델 ID와 요금, 이미지 입력 처리, 응답 길이까지 다시 확인해야 합니다.
552B 모델이 입력과 출력을 다르게 계산한다
공식 모델 카드에 따르면 V4.1 Flash는 전체 백본 파라미터가 552B인 MoE 모델입니다. 모든 파라미터를 토큰마다 사용하는 구조는 아닙니다. 입력을 미리 계산하는 프리필 단계에서는 토큰당 8B, 답변을 만드는 디코드 단계에서는 16B 파라미터를 활성화합니다. DeepSeek는 20개 인코더 층과 20개 디코더 층으로 구성한 Causal Encoder-Decoder 구조를 사용해 두 단계를 나눴습니다.
이 설계가 겨냥한 곳은 긴 지시와 많은 자료를 먼저 읽는 에이전트 작업입니다. 코딩 에이전트가 저장소 파일과 작업 기록을 길게 입력받는 경우처럼, 입력 분량이 출력보다 훨씬 큰 작업에서는 프리필에 쓰는 계산량과 캐시가 운영 비용에 영향을 줍니다. V4.1 Flash는 프리필의 활성 파라미터를 줄이고, 여러 디코더 층이 캐시 정보를 공유하도록 설계했습니다.
DeepSeek는 이전 V4 Flash와 비교해 전역 KV 캐시의 HBM 사용량을 약 4분의 1로, SSD 저장량을 약 8분의 1로 줄였다고 설명합니다. 이 비율은 V4.1 Flash의 특정 캐시 구조를 이전 세대와 비교한 수치입니다. 모델 전체의 메모리 사용량이나 API 청구액이 언제나 같은 비율로 줄어든다는 뜻은 아닙니다. 실제 비용에는 캐시 적중 여부와 입력·출력 토큰 수, 사용 시간대가 함께 작용합니다.
1M 컨텍스트와 이미지 입력을 한 모델 ID로 제공한다
공식 가격표에는 deepseek-flash의 컨텍스트 길이가 1M 토큰, 최대 출력이 384K 토큰으로 표시돼 있습니다. 텍스트 처리와 이미지 이해를 같은 모델 ID에서 제공하고, JSON 출력과 도구 호출, Responses API와 Anthropic API도 지원합니다. 사고 모드는 기본으로 켜져 있으며 API 형식에 맞는 설정으로 끄거나 추론 강도를 조절할 수 있습니다.
이미지는 JPEG, PNG, GIF, WebP 형식으로 보낼 수 있습니다. DeepSeek의 비전 가이드는 Base64 데이터, 외부 이미지 URL, Files API의 파일 ID를 입력하는 세 가지 방법을 안내합니다. 스크린샷의 글자를 읽거나 차트를 분석하는 요청을 기존 Flash API 흐름에 넣을 수 있다는 의미입니다. 다만 이미지도 크기에 따라 토큰으로 바뀌어 텍스트 입력과 함께 과금됩니다. 1M 컨텍스트를 지원한다는 사실만으로 긴 입력이나 많은 이미지를 비용 제한 없이 처리할 수 있는 것은 아닙니다.
오픈 웨이트도 함께 공개됐습니다. Hugging Face 모델 카드는 가중치에 MIT 라이선스를 적용하고, 로컬 추론을 위한 변환과 실행 안내를 별도 폴더에서 제공합니다. 552B 백본과 긴 문맥을 다루는 모델이므로 개인용 그래픽카드 한 장에서 간단히 실행하는 경량 모델로 보기는 어렵습니다. DeepSeek도 대규모 배포 상담의 예로 GPU 2,000개와 스토리지 클러스터를 제시했습니다. 직접 운영하려는 조직은 API 가격뿐 아니라 하드웨어와 캐시 저장 공간, 추론 소프트웨어 지원 상황을 함께 계산해야 합니다.
기존 Flash 모델은 이미 제공이 종료됐다
이번 발표와 함께 deepseek-v4-flash와 deepseek-v4-flash-vision-exp가 가리키던 기존 모델은 제공이 종료됐습니다. 두 모델 ID는 당분간 요청을 받지만, 실제 처리는 V4.1 Flash가 담당하고 Flash 요금이 적용됩니다. 호환을 위한 임시 연결이므로 새 프로젝트에서는 deepseek-flash를 쓰는 편이 현재 공식 안내와 맞습니다.
기존 모델 ID를 유지해도 실제로 응답하는 모델은 바뀝니다. 기존 ID를 사용하는 서비스도 출력 품질과 응답 형식이 달라질 수 있습니다. 이미지 입력을 실험 모델에 연결했던 경우에는 deepseek-flash로 바꾼 뒤 지원 형식과 이미지 토큰 사용량을 다시 확인할 필요가 있습니다. 운영 중인 프롬프트와 도구 호출, 구조화 출력 검사를 새 모델을 기준으로 한 번 더 실행해야 합니다.
V4 Pro 요청도 9월 14일부터 Flash로 연결된다
DeepSeek는 9월 14일 04시 UTC부터 deepseek-v4-pro 요청을 V4.1 Flash로 연결한다고 밝혔습니다. 한국 시간으로는 같은 날 오후 1시입니다. 이 조치는 향후 V4.1 Pro가 출시될 때까지 이어지며, 전환된 요청에는 V4.1 Flash 요금이 적용됩니다. 9월 10일 현재 V4.1 Pro는 출시된 모델이 아닙니다.
회사는 여러 평가에서 V4.1 Flash가 기존 V4 Pro보다 성능과 비용, 속도, 전체 작업 시간에서 앞섰다고 발표했습니다. 모델 카드의 에이전트 평가에서는 Terminal-Bench 2.1 90.6, DeepSWE v1.1 74.2, CyberGym 88.1을 제시합니다. 이 결과는 최대 추론 강도와 지정된 에이전트 실행 환경에서 측정한 회사 측 평가입니다. 코드 에이전트 항목에는 1M 컨텍스트와 벤치마크별 실행 도구 등의 조건이 붙습니다. 세 점수만으로 모든 일반 대화와 코딩 작업에서 다른 모델보다 낫다고 결론내릴 수는 없습니다.
이미 V4 Pro를 운영 환경에 연결했다면 9월 14일 전에 회귀 검사를 마치는 편이 좋습니다. 같은 모델 ID가 다른 모델로 연결되므로, 코드 수정 정확도와 도구 호출 횟수, 출력 형식, 처리 시간의 변화를 따로 측정해야 합니다. V4 Pro의 현재 결과를 보존해야 하는 작업이라면 임시 라우팅이 시작되기 전에 응답과 평가 기준을 기록해 두는 것도 필요합니다.
비피크 시간에는 공개 단가가 절반으로 내려간다
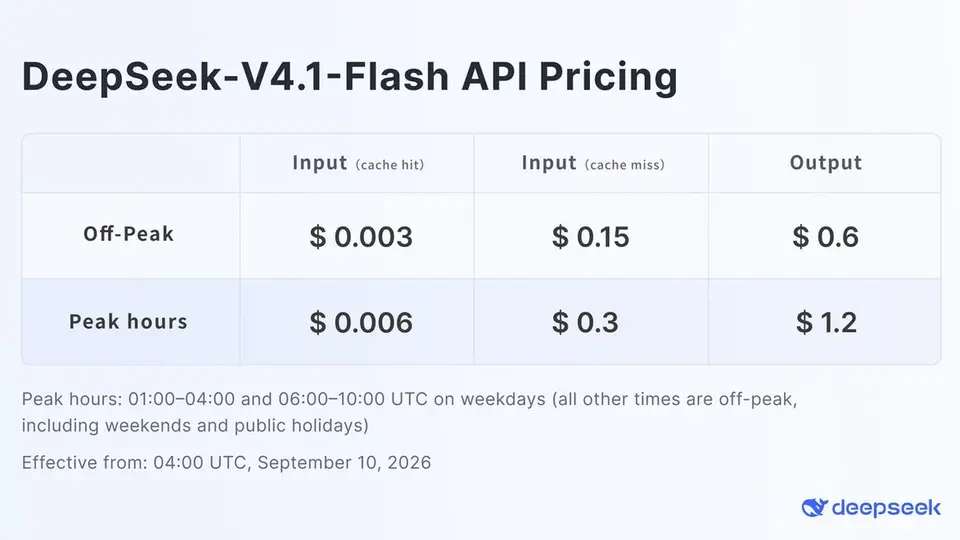
V4.1 Flash의 API 가격은 100만 토큰 기준으로 공개돼 있습니다. 피크 시간에는 캐시 적중 입력 0.006달러, 캐시 미적중 입력 0.30달러, 출력 1.20달러입니다. 비피크 시간에는 각각 0.003달러, 0.15달러, 0.60달러로 절반이 됩니다. 새 가격은 9월 10일 04시 UTC부터 적용됐습니다.
피크 시간은 월요일부터 금요일까지 01시부터 04시 UTC, 06시부터 10시 UTC입니다. 한국 시간으로 바꾸면 평일 오전 10시부터 오후 1시, 오후 3시부터 오후 7시입니다. 그 밖의 시간에는 비피크 단가가 적용됩니다. 대량 문서 처리나 예약할 수 있는 배치 작업은 시간대를 옮겨 비용을 줄일 수 있습니다. 실시간 응답이 필요한 서비스는 낮은 단가만 보고 요청을 늦출 수 없으므로, 실제 트래픽 시간과 캐시 적중률을 함께 봐야 합니다.
API 사용자는 모델명보다 전환 조건을 먼저 확인해야 한다
새로 V4.1 Flash를 쓴다면 모델 ID를 deepseek-flash로 지정하고, 텍스트와 이미지 입력을 각각 시험하는 것이 첫 단계입니다. 기존 Flash 사용자는 임시 라우팅에 기대기보다 새 ID로 바꾸고 구조화 출력과 도구 호출을 점검해야 합니다. V4 Pro 사용자는 9월 14일 전환 시각을 기준으로 전후 결과를 비교해야 합니다. 공식 발표만으로 기존 서비스의 프롬프트가 그대로 작동한다고 보장할 수 없기 때문입니다.
가격을 비교할 때도 입력 단가 하나만 보기는 어렵습니다. 긴 컨텍스트를 자주 다시 보내는지, 캐시가 실제로 얼마나 적중하는지, 출력이 얼마나 길어지는지에 따라 청구액이 달라집니다. 이미지 입력은 텍스트와 함께 토큰으로 계산됩니다. DeepSeek V4.1 Flash의 변화는 긴 입력과 에이전트 작업의 처리 효율을 높이는 데 초점이 맞춰져 있습니다. 실제 도입 여부는 자신의 요청 구성과 운영 시간대에서 품질, 지연 시간, 총비용을 함께 측정한 뒤 결정하는 편이 안전합니다.
Meta Muse Glimmer, 내 컴퓨터에서 실행하는 30B 에이전트 모델
Meta가 공개한 Muse Glimmer는 개인 컴퓨터에서 도구를 쓰고 여러 단계의 작업을 수행하도록 만든 30B급 모델입니다. 공개된 GGUF 파일 구성과 메모리 요구량, 속도 측정 조건을 살펴봅니다.
Gemini 3.8 Flash와 Cyber 공개, 같은 Flash 이름 아래에서 달라진 접근 범위와 비용
Google이 Gemini 3.8 Flash와 보안 전용 Gemini 3.8 Flash Cyber를 공개했습니다. 일반 Flash는 더 많은 추론과 도구 호출을 쓸 수 있어, 단가가 같은 도입 기간에도 총 토큰 비용은 작업 방식에 따라 달라집니다.