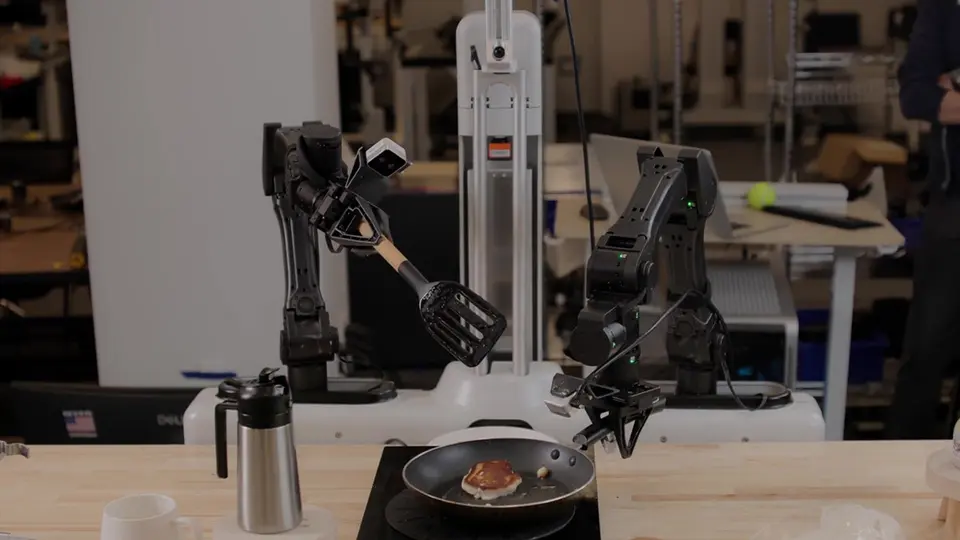
Skild AI의 로봇 기초 모델 S1을 NVIDIA가 9월 10일 생산 현장과 개발 인프라 관점에서 소개했습니다. S1은 사람이 작업하는 영상 한 편을 보고 로봇이 같은 목적의 동작을 수행하도록 설계됐습니다. 새 작업마다 모델 가중치를 다시 학습하거나 별도의 작업별 추가 학습을 거치지 않습니다.
시범 영상과 실제 로봇의 시점, 주변 배치, 몸체가 달라도 모델이 물체와 순서를 해석해 현재 로봇의 동작으로 바꿉니다. Skild AI는 이를 로봇의 인컨텍스트 학습이라고 부릅니다.
영상을 추가 학습 없이 작업 지시로 활용한다
기존 산업용 로봇은 공정이 바뀔 때 새 데이터를 모으고 해당 작업에 맞춰 정책을 다시 조정하는 경우가 많습니다. S1에서는 작업자가 먼저 원하는 동작을 영상으로 보여줍니다. 모델은 그 영상을 실행 시점의 문맥으로 받아 사전 학습 때 보지 못한 작업에도 같은 가중치를 사용합니다.
Skild AI가 공개한 예시는 화분에 식물 옮겨 심기, 팬케이크 만들기, 핸드드립 커피 내리기, 부품 키트 조립입니다. 각 작업은 수십 개의 조작 단계로 이어지고 가장 긴 시연은 약 10분입니다. 팬케이크를 뒤집거나 커피 필터를 드리퍼 안에 누르는 동작처럼 학습 자료에 없던 행동도 영상 지시를 바탕으로 수행했다고 회사는 설명합니다.
화분 작업에서는 시범 촬영을 마친 시각이 오후 9시 22분, 로봇의 자율 실행 시작이 9시 27분으로 기록됐습니다. 사무실에 재료가 도착한 뒤 공간을 배치하고 영상을 찍는 시간까지 합치면 33분이지만, 시범 영상에서 실제 실행으로 넘어가는 데에는 5분이 걸렸습니다. NVIDIA가 언급한 11분은 녹화 시작부터 자율 실행까지의 시간입니다. 어느 구간을 재느냐에 따라 숫자가 달라집니다.
이 방식이 모든 동작을 한 번에 성공시킨다는 뜻은 아닙니다. Skild AI는 물체 위치를 바꾸거나 조명을 달리한 시연, 실패 뒤 다시 시도하는 장면을 공개했습니다. 이런 사례는 대응 행동이 나타났다는 정성적 증거이며, 여러 환경에서 같은 수준으로 재현된다는 보증과는 구분해야 합니다.
66%는 작업 전체 성공률이 아니다
가장 눈에 띄는 수치는 보지 못한 다단계 작업에서 S1이 기록한 66%입니다. 비교 대상인 언어 지시 기반 VLA 정책은 9%였습니다. 두 모델은 10만 시간 규모에서 같은 데이터와 계산량, 거의 같은 구조를 사용했고 프롬프트를 표현하는 부분이 달랐다고 Skild AI는 설명합니다.
여기서 66%는 작업 하나를 처음부터 끝까지 완수한 비율이 아닙니다. 4∼8분 길이의 내부 평가 작업에서 각 단계까지 연속으로 성공한 정도를 평균한 ‘누적 단계별 성공률’입니다. 연구진은 뒤 단계도 채점할 수 있도록 실패 뒤 사람이 개입해 로봇을 복구했으며, 이 개입은 전체 긴 작업을 한 번도 끝내지 못한 비교 모델에 주로 사용됐습니다.
평가 결과를 읽을 때는 세 가지 범위를 함께 봐야 합니다.
- Skild AI가 만든 내부 벤치마크이며 과제와 채점 자료가 외부 기관에서 검증된 결과는 아닙니다.
- 66%와 9%는 보지 못한 작업, 10만 시간 사전 학습 조건에서 비교한 단계별 수치입니다.
- 실제 공장에서 요구하는 작업 전체 완료율, 처리 속도, 안전 정지 횟수는 이번 결과에 제시되지 않았습니다.
Skild AI는 영상 시범 한 편의 효과가 약 380회의 원격 조작 학습 예시에 해당한다고 추정했습니다. 정확히 측정된 교차점이 아니라 측정 지점 사이를 보간한 값입니다. 회사는 긴 작업의 시범 380개를 수집하려면 원격 조작에 50∼100시간이 들 것으로 추산했습니다. 2,000개의 원격 조작 시범으로 추가 학습한 비교 모델은 같은 지표에서 86%에 도달했습니다. 한 번 보여주는 방식은 배치 속도에 강점이 있고, 충분한 전용 학습은 단계별 성공률을 더 높일 수 있다는 결과입니다.
범용성은 데이터와 시뮬레이션에서 만든다
S1은 로봇 영상만으로 훈련된 모델이 아닙니다. Skild AI는 원격 조작, 1인칭 사람 영상, 시뮬레이션 등 서로 다른 자료를 섞습니다. 원격 조작은 실제 하드웨어와 가깝지만 수집 비용이 크고, 사람 영상은 다양하게 모으기 쉽지만 로봇 동작과 차이가 큽니다. 시뮬레이션은 대량 생성이 가능해도 현실의 접촉과 마찰을 그대로 옮기기 어렵습니다.
NVIDIA는 이 과정에서 Cosmos로 영상 자료를 설명·분류하고, Omniverse와 Isaac Sim으로 가상 환경과 예외 상황을 만들며, Isaac Lab에서 강화 학습을 진행한다고 밝혔습니다. 실제 배치 단계에서는 TensorRT로 추론을 최적화합니다. 영상 한 편이 즉석에서 능력을 만드는 것처럼 보여도, 그 전에 다양한 몸체와 작업을 다룬 대규모 사전 학습이 있어야 한다는 구조입니다.
Skild AI, NVIDIA, Foxconn은 듀얼 암 로봇에 Skild Brain을 배치해 NVIDIA Blackwell 시스템 조립을 진행하고 있습니다. 공개된 흐름에는 버스바와 리미트 블록 설치, 나사 16개 체결, 중간 방해 상황에 대한 대응이 들어갑니다. 다만 NVIDIA 발표는 이 생산 배치의 가동 규모와 불량률, 사람 대비 처리 시간을 공개하지 않았습니다. Skild Brain의 현장 배치가 S1 내부 벤치마크 수치를 그대로 입증하는 자료도 아닙니다.
가중치·API·가격은 발표문에 없다
두 회사의 발표에는 S1 모델 가중치, 공개 API, 라이선스, 사용 가격이 없습니다. Skild AI는 향후 업데이트와 얼리 액세스, 도입 문의를 받을 신청 창구를 마련했습니다. 개발자가 모델을 내려받아 임의의 로봇에 설치하는 공개 배포보다 파트너 현장에 맞춰 공급하는 단계로 보는 편이 정확합니다.
기업이 검토할 지점은 데모 영상의 인상보다 공정 변경 비용입니다. 새 작업을 가르치는 시간이 몇 시간에서 몇 분으로 줄어드는지, 한 번의 시범 뒤 어느 단계에서 사람이 개입하는지, 안전 검증을 다시 거쳐야 하는 범위가 어디까지인지가 실제 도입 가치를 정합니다. S1은 한 영상으로 긴 작업을 지시하는 가능성을 보여줬지만, 공개된 66%만으로 무인 공정의 완성도를 판단할 수 있는 단계는 아닙니다.
월드랩스 Atlas 공개, 카메라를 제어하는 월드 모델과 조기 접근
월드랩스가 텍스트·이미지·영상·3D를 함께 다루는 월드 모델 Atlas를 공개했습니다. 1분 길이 1440p 영상, 공간 재구성, 로봇 시뮬레이션 기능과 선별 파트너 조기 접근 범위를 살펴봅니다.
Gemini가 영상 구간을 스스로 탐색한다: 에이전트형 영상 이해의 비용·정확도 조건
Google이 Gemini API에 에이전트형 영상 이해를 추가했습니다. 긴 영상에서 어떤 구간과 신호를 볼지 모델이 고르는 방식이지만, 짧은 영상과 빠른 응답이 필요한 경우에는 기존 정적 처리도 여전히 맞습니다.